Faut-il supprimer ton CLAUDE.md ?
#Le problème : un fichier qui grossit sans fin
Tu as commencé avec 20 lignes dans ton CLAUDE.md. Les conventions de code, les commandes de build, le workflow git. Puis tu as ajouté les patterns React, les règles de testing, les standards d'API, les consignes de sécurité... Six mois plus tard, ton fichier fait 400 lignes et Claude semble ignorer la moitié de ce que tu lui demandes.
Ce n'est pas un bug. C'est un problème de budget d'instructions.
Les modèles de langage ont une capacité limitée à suivre des instructions simultanées. Les benchmarks montrent qu'un modèle comme Claude peut suivre environ 150 à 200 instructions de manière fiable. Le prompt système de Claude Code en consomme déjà une cinquantaine. Il te reste donc un budget d'environ 100 à 150 instructions — et ton CLAUDE.md partage ce budget avec les règles, les skills et l'historique de conversation.
Quand tu dépasses ce budget, Claude ne plante pas. Il fait pire : il priorise silencieusement certaines instructions et en ignore d'autres, sans te prévenir.
#La tentation de tout supprimer
Face à ce constat, une réaction naturelle est de tout raser. L'article "You Don't Need a CLAUDE.md" défend cette approche : réduire le fichier à 30 lignes maximum et stocker la documentation dans un dossier docs/ que Claude consulte à la demande.
L'idée est séduisante mais elle rate un point important : le CLAUDE.md bénéficie d'une priorité haute dans le contexte de Claude. Les instructions qui s'y trouvent ont plus de poids que celles découvertes en cours de session. Supprimer le fichier, c'est perdre ce canal privilégié.
La vraie question n'est pas "faut-il supprimer le CLAUDE.md ?", mais plutôt "que faut-il y garder ?"
#Le contexte passif bat la récupération active
En janvier 2026, Vercel a publié une découverte qui éclaire bien le débat. Leur équipe a mesuré la capacité des agents IA à utiliser correctement les nouvelles APIs de Next.js 16 — des APIs comme use cache ou connection() absentes des données d'entraînement des modèles.
Le résultat est sans appel. Un index compressé de 8 Ko embarqué directement dans le fichier AGENTS.md (l'équivalent du CLAUDE.md pour les outils multi-agents) atteint 100% de réussite sur tous les tests — build, lint et tests unitaires.
Le système de Skills, pourtant plus sophistiqué, plafonne à 79% même avec des instructions explicites demandant à l'agent de les utiliser.
L'explication tient en une phrase : avec un contexte passif, l'agent n'a jamais besoin de décider s'il doit chercher l'information. Elle est déjà là. Avec les Skills, il y a un moment de décision ("est-ce que j'ai besoin de cette documentation ?") et l'agent fait parfois le mauvais choix.
Vercel a réduit leur injection documentaire de 40 Ko à 8 Ko (une réduction de 80%) en utilisant un format compressé délimité par des pipes. L'agent consulte un index pointant vers des fichiers de référence plutôt que d'avoir tout le contenu en contexte.
#La solution : un CLAUDE.md léger + des règles modulaires
La réponse n'est ni de supprimer le fichier, ni de le garder tel quel. C'est de le restructurer en utilisant le système de règles modulaires de Claude Code.
#Le principe
Depuis la version 2.0.64, Claude Code supporte un dossier .claude/rules/ qui contient des fichiers Markdown chargés automatiquement avec la même priorité que le CLAUDE.md. La différence clé : ces fichiers peuvent être conditionnels, chargés uniquement quand Claude travaille sur certains types de fichiers.
mon-projet/
├── .claude/
│   ├── CLAUDE.md           # 60 lignes max — le "quoi" et le "pourquoi"
│   └── rules/
│       ├── code-style.md   # Conventions de code
│       ├── testing.md      # Standards de test
│       ├── api.md          # Patterns API
│       └── security.md     # Règles de sécurité
#Ce qui reste dans le CLAUDE.md
Ton CLAUDE.md racine doit répondre à trois questions : quoi, pourquoi et comment.
Quoi — la stack technique, la structure du projet, les dépendances majeures.
Pourquoi — le contexte métier, les décisions d'architecture et leur justification. C'est ce qui aide Claude à faire les bons choix quand il doit improviser.
Comment — les commandes exactes pour builder, tester et vérifier. C'est la section que Claude consulte le plus souvent.
Vise un fichier de 60 à 100 lignes maximum. Chaque instruction doit être universellement applicable à toutes tes sessions. Si une règle ne concerne que les fichiers React ou que les migrations de base de données, elle va dans une règle scopée.
#Les règles scopées par chemin
C'est la fonctionnalité qui change tout. Tu peux cibler une règle sur des fichiers spécifiques avec un frontmatter YAML :
---
paths:
  - "src/api/**/*.ts"
---

# Règles API

- Valider tous les inputs avec Zod
- Retourner un format d'erreur consistant
- Documenter chaque endpoint avec des commentaires OpenAPI
Cette règle ne se charge que quand Claude travaille sur des fichiers dans src/api/. Tes conventions API n'encombrent plus le contexte quand tu édites un composant React.
| Pattern | Fichiers ciblés |
|---|---|
| `src/api/**/*.ts` | Tous les TypeScript dans src/api/ |
| `**/*.test.ts` | Tous les fichiers de test |
| `src/components/**/*.tsx` | Tous les composants React |
| `prisma/migrations/**/*` | Les migrations de base de données |
| `src/**/*.{ts,tsx}` | TypeScript et TSX dans src/ |
#Avant / Après
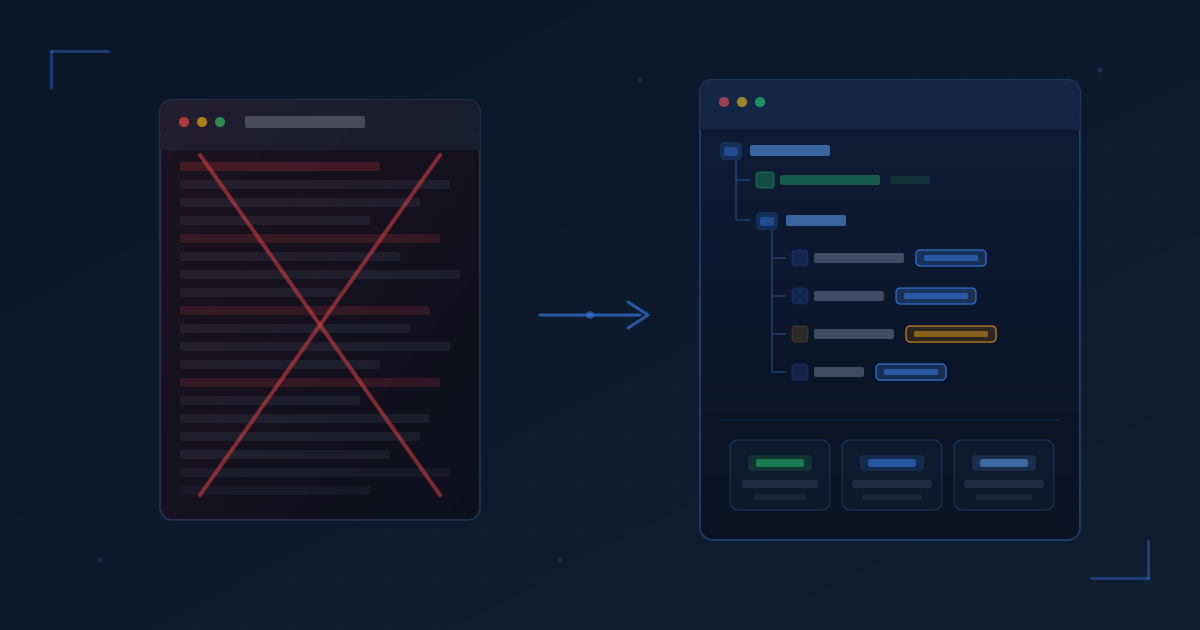
Avant : un CLAUDE.md de 400 lignes. Les règles API, React, testing et sécurité se battent toutes pour l'attention de Claude, tout le temps.
Après : un CLAUDE.md de 80 lignes + 4 fichiers de règles ciblées. Chaque règle n'obtient la priorité haute que quand elle est pertinente.
Avant : 400 lignes en haute priorité → tout le temps
Après : 80 lignes universelles + règles ciblées → quand c'est pertinent
Le résultat ? Claude suit mieux tes instructions parce qu'il en reçoit moins à chaque instant.
#Migration pas à pas
Si tu as déjà un gros CLAUDE.md, voici comment migrer sans tout casser.
1. Identifie les blocs thématiques. Relis ton fichier et marque les sections : style de code, testing, API, sécurité, workflow git, etc.
2. Crée le dossier de règles.
mkdir -p .claude/rules
3. Déplace chaque bloc dans un fichier dédié. Pour chaque section identifiée, crée un fichier dans .claude/rules/ avec un frontmatter paths si la règle ne s'applique qu'à certains fichiers.
4. Nettoie le CLAUDE.md racine. Ne garde que ce qui est universel : la stack, le contexte projet, les commandes de build et test.
5. Teste sur une session fraîche. Lance Claude Code et vérifie que les règles se chargent correctement avec la commande /memory.
Ne délègue pas à un linter ce que Claude ne devrait pas gérer. Les règles de formatage (indentation, guillemets, points-virgules) sont mieux servies par ESLint et Prettier. Chaque instruction de style dans ton CLAUDE.md gaspille une place dans le budget d'instructions.
#Bonnes pratiques
Un sujet par fichier. Un fichier api-validation.md est plus clair que rules1.md. Le nom du fichier doit indiquer son contenu.
Utilise le path-scoping avec parcimonie. Ne scope que les règles qui sont vraiment spécifiques à un type de fichier. Les conventions universelles (nommage, gestion d'erreurs) restent dans le CLAUDE.md.
N'automatise pas la génération. La commande /init produit un CLAUDE.md générique qui consomme du budget pour peu de valeur. Écris chaque ligne à la main — c'est ton fichier le plus impactant.
Préfère les pointeurs aux copies. Plutôt que de coller un extrait de code dans une règle, référence le fichier source : "Voir src/lib/auth.ts pour le pattern d'authentification". Claude ira le lire quand il en aura besoin.
Revois régulièrement. Ton projet évolue, tes règles aussi. Supprime les instructions devenues obsolètes plutôt que d'en empiler de nouvelles.
#Ce qu'il faut retenir
Le CLAUDE.md n'est pas un wiki. C'est un canal de communication à haute priorité avec un budget limité. Chaque ligne compte.
La réponse à "faut-il supprimer ton CLAUDE.md ?" est non — mais il faut probablement le réduire de 80% et déplacer le reste dans des règles modulaires ciblées.
Un CLAUDE.md de 60 lignes bien écrites sera toujours plus efficace qu'un pavé de 400 lignes que Claude parcourt en diagonale.